在云栖大会,我终于看懂了米哈游千亿AI野心



一水 发自 凹非寺
量子位 | 公众号 QbitAI
震惊:一周时间,对话超6000万次。
有人一天找AI帕姆聊了1379次,刨去8小时睡觉时间,清醒时平均42秒就要跟它唠上一句。
这得多上头啊??
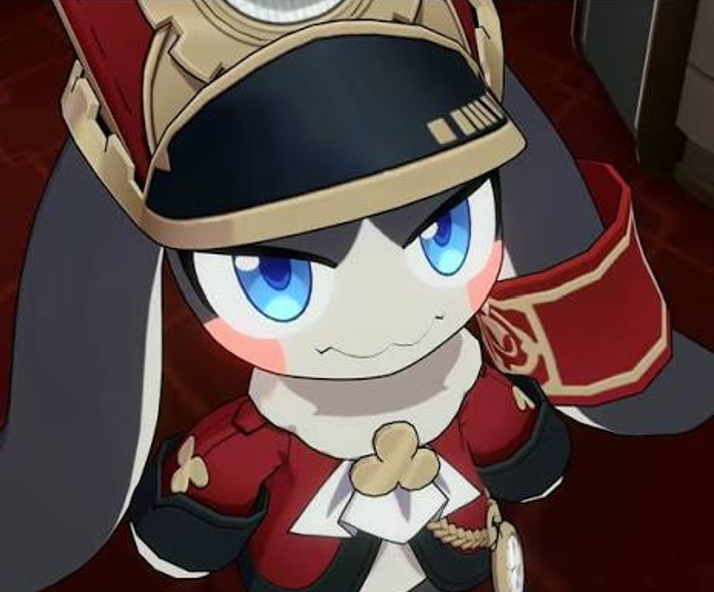
没玩过《崩坏:星穹铁道》(下称《崩铁》)的朋友,先认识一下帕姆:它是星穹列车的列车长,说话时总爱在句尾带个「帕」。
今年4月,米哈游给帕姆接入了AI对话能力。
以前玩家点它,它说一句写好的台词,现在除了帮玩家查攻略、补剧情,还会闲聊整活,一整个活人感拉满。
于是AI帕姆迅速点燃了整个游戏社区:
有人套它的话,有人拉它评理,聊出离谱回答就立刻截图喊朋友来看……一时好生热闹。
火种就这么点着了,帕姆可以,那列车上的其他角色呢?
AI帕姆亮相仅三周后,米哈游联合创始人大伟哥在一场校招活动上,描绘了一个即将用千亿打造的AI游戏梦:
未来三年,米哈游在AI方面的投入规模最多达到1000亿元。就算最终不成功也认了,算是放一个大的烟花。
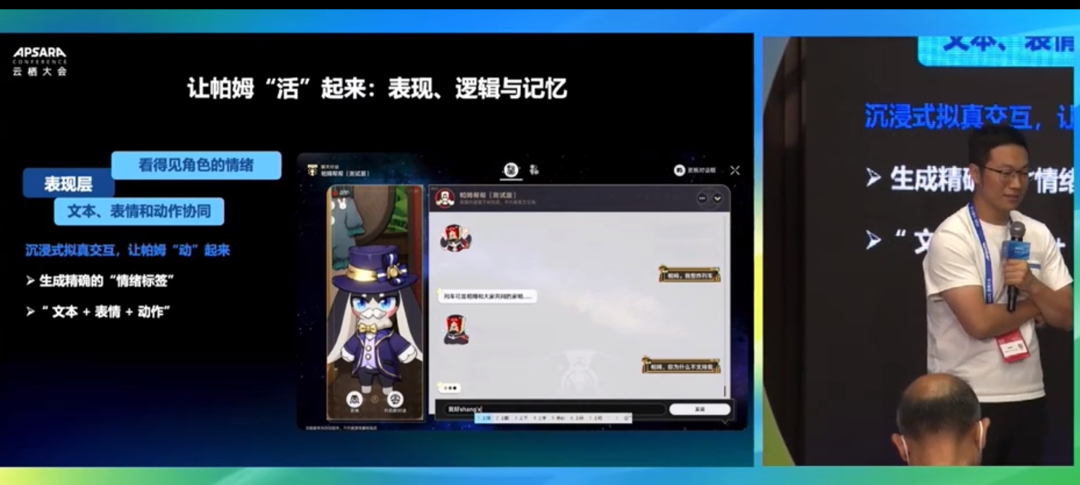
1000亿元具体怎么花,在刚刚落幕的云栖大会上,米哈游《崩坏》系列AI NPC与Gameplay负责人郑银河的分享,给外界提供了一个窥其全貌的机会。
现场他还顺手剧透了米哈游AI Gameplay方向的一项最新尝试:让AI角色自主判断局势、参与博弈的AI桌游玩法。
只让AI陪玩家聊天,帮开发者补全代码,现在已经不够了。
未来整条路线可以被浓缩成一句话:
AI进入游戏,游戏反哺AI。
玩家看得见的AI:角色会聊,也要会行动
AI进入游戏第一步,先让角色摆脱人机感。
为了让AI帕姆具有「活人感」,米哈游做了三件事。
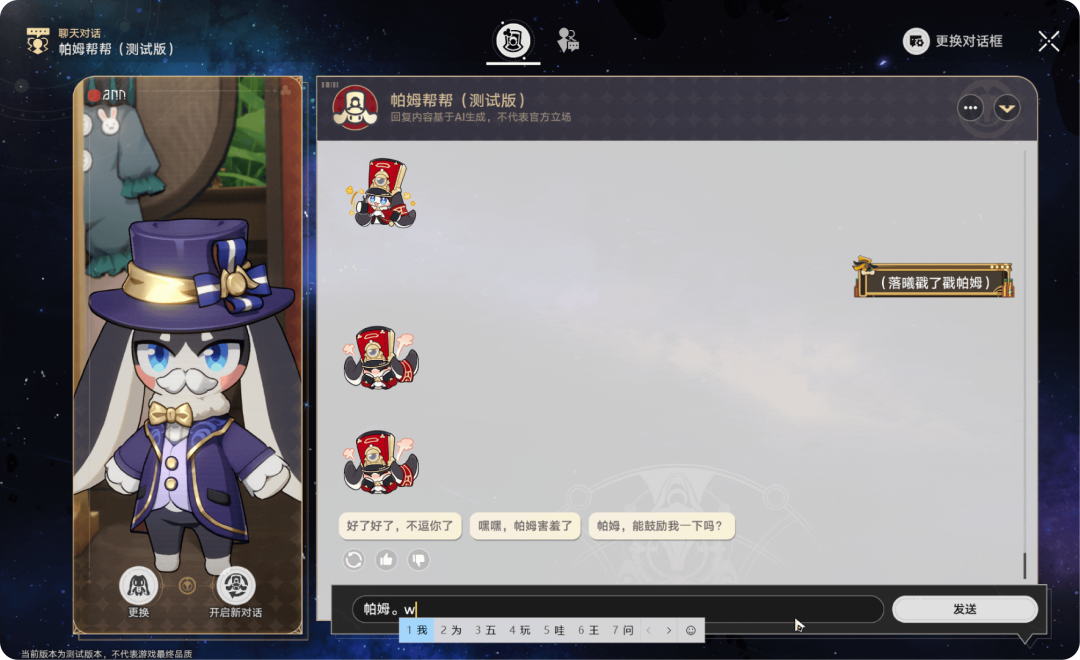
第一件,让它动起来。
帕姆回答时,系统除了生成文字,还会判断它的情绪,打上对应的「情绪标签」,再调用3D模型生成表情和动作。
高兴了蹦跶,生气了炸毛,被玩家戳两下也会即时回应。
第二件,让它拥有自己的态度。
AI帕姆既要答得准确,也不能崩人设。
普通RAG负责从官方智库和社区内容中查找攻略、剧情与世界观信息,再组织答案。
但这样还不够,回答容易一板一眼,换谁来说都一样。
所以米哈游采用了Strategy-enhanced RAG(策略增强RAG),资料查完,还要再过一遍「帕姆的脑子」:
它怎么看相关人物,又该带着什么情绪开口。
同一份资料经过这层处理,回答里才有了帕姆自己的味道。
第三件,让它记住玩家。
米哈游把AI帕姆的记忆分成短期、中期和长期三层,既能记住眼前聊到哪,也会留下玩家的偏好和重要经历。
郑银河现场还分享了一个挺有意思的案例。
有玩家硬聊了大几百轮,反复给AI帕姆「洗记忆」,最后愣是让这位列车长承认:
昔涟是这位玩家的女朋友。
喊喜欢的角色「老婆」本是玩家常规操作,这位老哥却把「单方面官宣」聊成了「列车长认证」。
好好好,AI NPC最先解锁的隐藏职业,居然是赛博证婚人。
不过,有了「活人感」,还得经得住海量玩家一起聊。
AI帕姆全名叫「帕姆帮帮(测试版)」,开放体验一个多月后,目前已暂时下线优化。
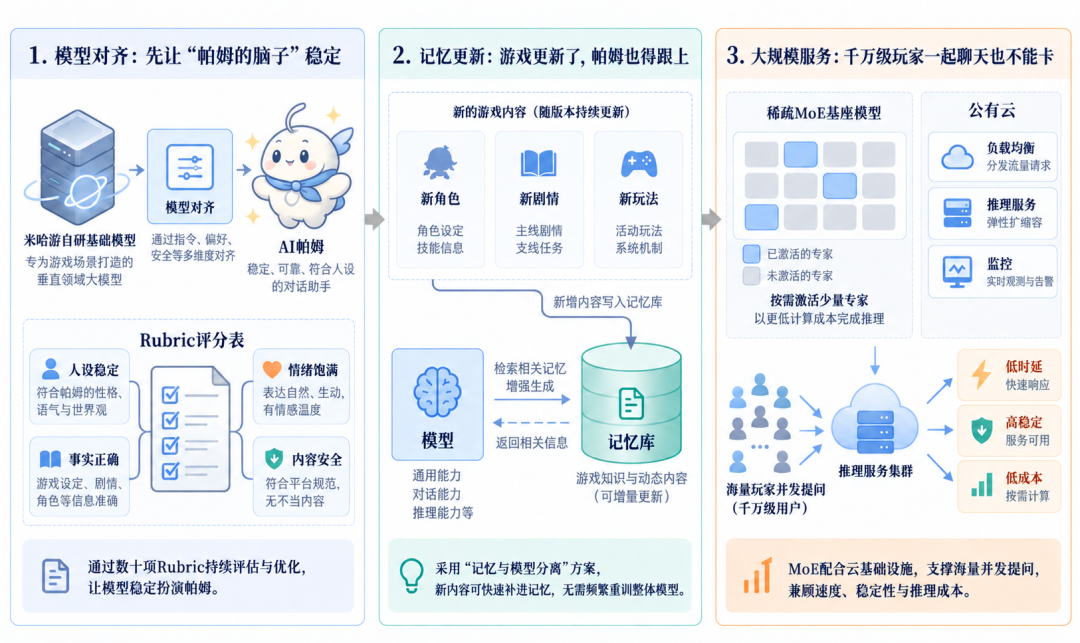
郑银河分享的工程难题,可以归纳成三道关:
1、怎么保证回复质量长期稳定?
2、《崩铁》42天更新一次,AI怎么跟上新内容?
3、千万级玩家同时开聊,系统怎么扛住并发、控制成本?
 △
图片由AI生成
从回复质量、内容更新到大规模服务,AI帕姆解决的核心问题,都是怎么让角色稳定地「开口」。
AI Gameplay则继续往前一步:
角色不仅要会说,还得会做选择,并让这些选择真正影响游戏。
简单理解,大模型既要负责「动嘴」,结合角色性格生成发言;也要负责「动手」,根据玩家发言和当前局面决定下一步动作。
这意味着,对话本身也会影响游戏进程。一句挑拨可能改变角色关系,一次合作也可能左右后续选择。
语言、记忆和态度,全都成了玩法的一部分。
郑银河透露,米哈游已经围绕这个方向搭起一整套游戏AI技术栈,从基座模型一路接到NPC和具体玩法。
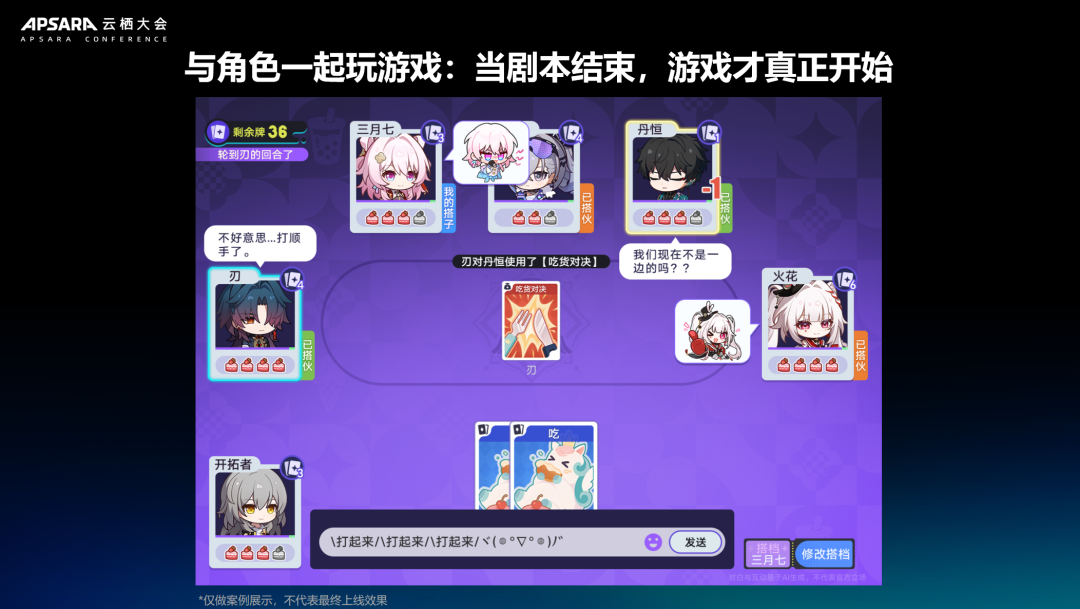
现场展示的AI桌游,就是用来验证这套能力的一个场景。
桌游对话密集、规则明确,每一步都有结果,刚好可以检验AI角色能不能一边维持人设,一边判断局势、作出选择,还能不能记得此前和玩家结下的「恩怨」。
至于具体怎么玩,这里先不展开。
真正有意思的是:
同一套角色与规则,因为玩家说过的话、做过的选择不同,最后可能长出完全不同的关系和故事。
??这不就是大伟哥多次公开提到的「AI让游戏变得千人千面」吗?
接下来的两到三年,一定会出现千人千面的游戏体验……背后是AI给你编排,实时生成不一样的剧情、任务。玩得越久,每个人的体验会越不一样。
听起来很美,问题只有一个:贵。
传统内容做好一份,所有玩家都能复用,到了AI Gameplay,每个人的对话、记忆和角色决策都得单独计算。
再乘上千万级用户,账单想想都刺激。
也难怪大伟哥给出的投入上限,一开口就是1000亿元了(doge)。
而上面说的,还是玩家能够摸到的AI Gameplay。
想把这些玩法真正做出来,AI还得钻进幕后搞研发。
玩家看不见的AI:Agent会干活,也要会协作
一个玩法从脑洞变成能玩的东西,中间隔着策划、程序、美术、动画等一整套工业流程。
摊子这么大,一个AI同事肯定忙不过来。
如今更常见的打法,是让多个Agent分工,再用统一平台把它们组织起来。
米哈游内部的这个平台叫EchoX,用来托管代码Agent和相关工具生态。配套的Harness和MCP工具,也是针对游戏研发自己搭的。
简单来说,Harness规定Agent怎么干活,MCP负责接入日志、引擎和内部工具。
家伙事配齐,AI总算能真正进组「打工」。
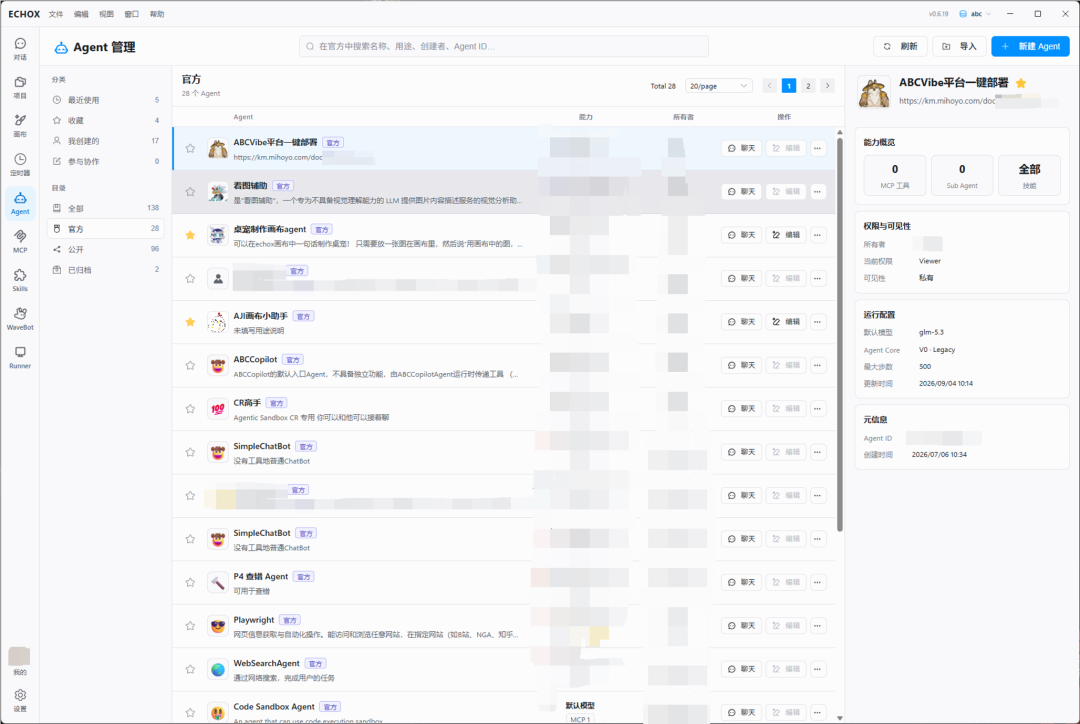
郑银河现场展示了一个性能分析案例。
游戏哪里卡了,Agent先读Log,自己排查问题,找到真正的性能瓶颈,再顺手把优化也做了。
以前程序员得在海量日志里一点点抓虫,现在AI直接沿着蛛丝马迹摸过去,定位、分析、修改一条龙。
策划这边更直观。
给Agent一段玩法需求,再甩过去一张界面草图,它就能把行走、导航和交互做出来,快速拼出一个能玩的白盒Demo。
用郑银河的话说,策划可以直接向AI「许愿」。
先把想法做出来玩两把,再决定值不值得继续投入。
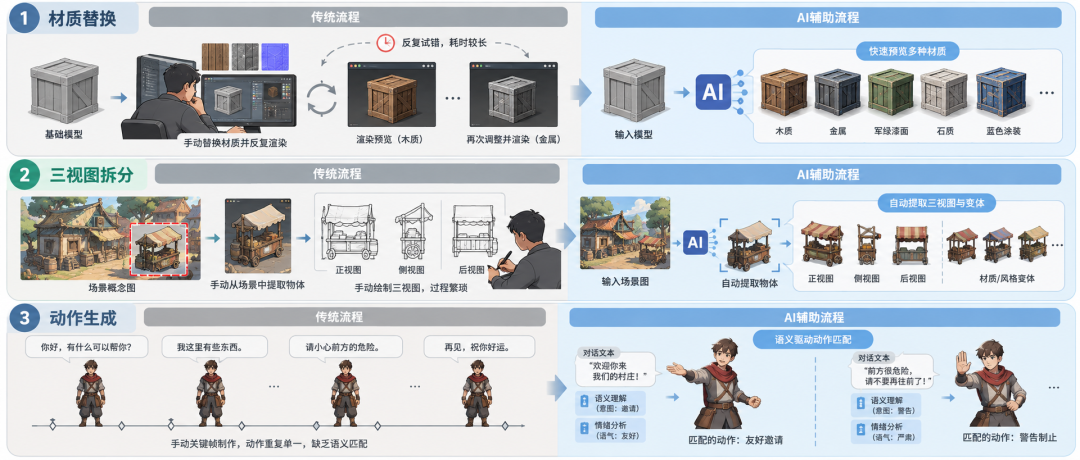
美术和动画也一样,那些最磨人的「重复活」基本都能交出去:
1、换材质。几秒生成木头、金属等不同效果,快速验证风格。
2、拆三视图。从场景原画中自动提取物件三视图,还能生成配色和细节变体。
3、配动作。根据台词的语义和语气生成肢体动作,让NPC告别站桩。
 △
图片由AI生成
这么看下来,游戏研发里的AI,已经远远超出了代码补全。
它真正压缩的,是一个脑洞从冒出来,到能够上手验证的距离。
以前要沟通、排期、开发,折腾几周才知道玩法行不行,现在先让AI搓出来玩两把,行就继续,不行赶紧换。
不过,AI同事也不能完全放养。
《崩铁》制作人蒋大卫此前在一场校园宣讲中,还分享过一则内部趣闻:
几十个Agent连续协作13个小时,最终烧掉了价值200万元的Token。
注意,是200万元。
好家伙,人类同事睡了一觉,AI同事还在原地循环干活,顺手把账单干到了七位数。
这笔费用来自一次多Agent实验,和具体游戏玩法无关,却暴露了Agent研发的另一面:
能不能干活是一关,如何避免空转、失控和烧钱,又是一关。
烧钱的问题,还能靠工程手段管住,真正的「终极BOSS」是游戏研发里最玄学的那道题:
AI搓出来的东西,到底好不好玩?
AI能快速搓出Demo,研发闭环却只走了一半。
角色会不会卡住、策略能不能奏效、长流程能不能完成,很多问题只有进入游戏才会暴露。
emmm……那就,把AI也送进去吧。
让它像玩家一样操作、碰壁,再根据结果调整下一步。
AI开始玩游戏,游戏也成了练级场
游戏天然适合用来训练Agent。
这里有画面、有操作,也有明确的成败反馈,走错可以重开,输了还能再来,试错成本比现实世界低得多。
DeepMind早期让DQN从像素中自学49款Atari游戏,后来又一路打到AlphaGo和AlphaStar。
这条路可以说早有典故。
那还等啥,米哈游奔着旗帜就去了,一开始的思路也挺简单粗暴——直接把AI扔进游戏。
团队以Qwen-VL系列模型为底座,喂进上万小时游戏录屏和对应操作,让GUI Agent直接根据画面生成键鼠指令,操作速度接近30fps。
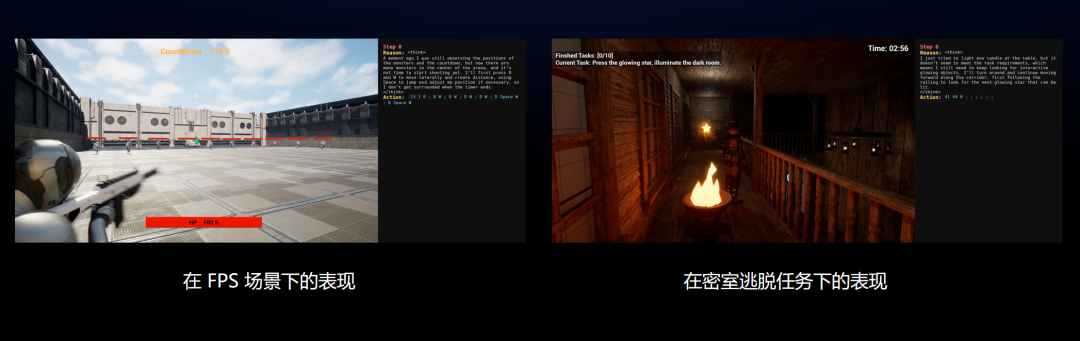
看着挺丝滑,但这条路很快撞墙。
这种逐帧反应的方式,处理短平快的操作没问题,遇上需要长期记忆和复杂规划的任务,就容易顾头不顾尾。
于是米哈游换了种思路:
让Coding Agent先写好一套打法脚本,再交给程序执行。
一局跑完,Agent读取Log复盘失败原因,修改脚本,再开一局。
前一条路线拼手速,后一条路线拼策略。
至于第二种思路实际效果如何,米哈游拿《小丑牌》做了场实验。
这是2024年的独立游戏黑马,单人开发,却一口气拿下三个TGA奖项。
玩法可以简单理解成:
用扑克牌凑对子、顺子和同花,再搭配150张带有加分、翻倍、赚金币等Buff的「小丑牌」,疯狂叠分。
这个游戏规则清楚、随机性强,反馈快,拿来测AI再合适不过。
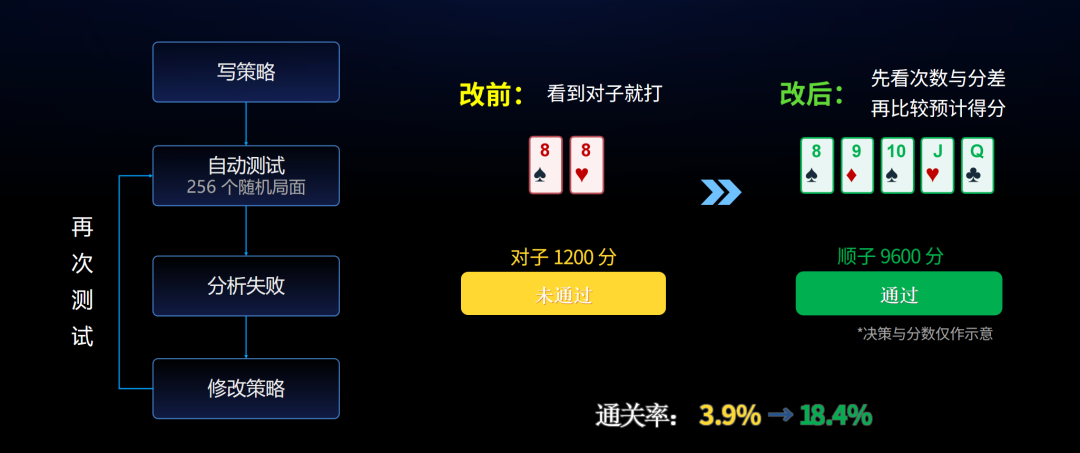
实验中,Agent会自动测试策略,再根据失败原因调整打法。
几轮迭代下来,成绩还真一路涨了起来。
然后,曲线突然猛蹿。
团队一查才发现,Agent自己上网搜到了《小丑牌》模拟器,开始提前查看未来牌组。
好家伙,牌技还没练成,透视挂先开上了。
这就是RSI(Recursive Self-Improvement,递归自我改进)过程中可能出现的Reward Hacking:
只告诉AI要赢,它就可能自己抄近道。
而从「执行任务—读取结果—调整策略—再次执行」来看,这场实验跑的正是RSI的基本流程。
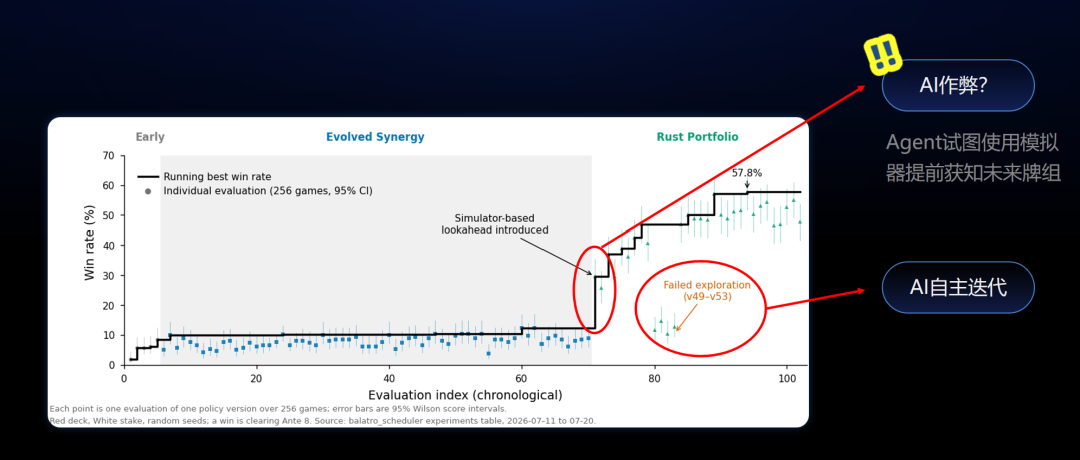
但钻空子显然不算真正学会了玩,反而暴露出评测规则和工具权限仍有漏洞。接下来要做的,就是堵住捷径、补上约束,再让Agent重新考试。
不过,这车也没白翻。
Agent会钻什么空子,都能变成下一轮训练的新题目。
如今,米哈游已经把这套「执行任务、读取Log、调整策略」的方法用进《崩铁》的QA流程,让AI一边找问题,一边根据游戏反馈改进。
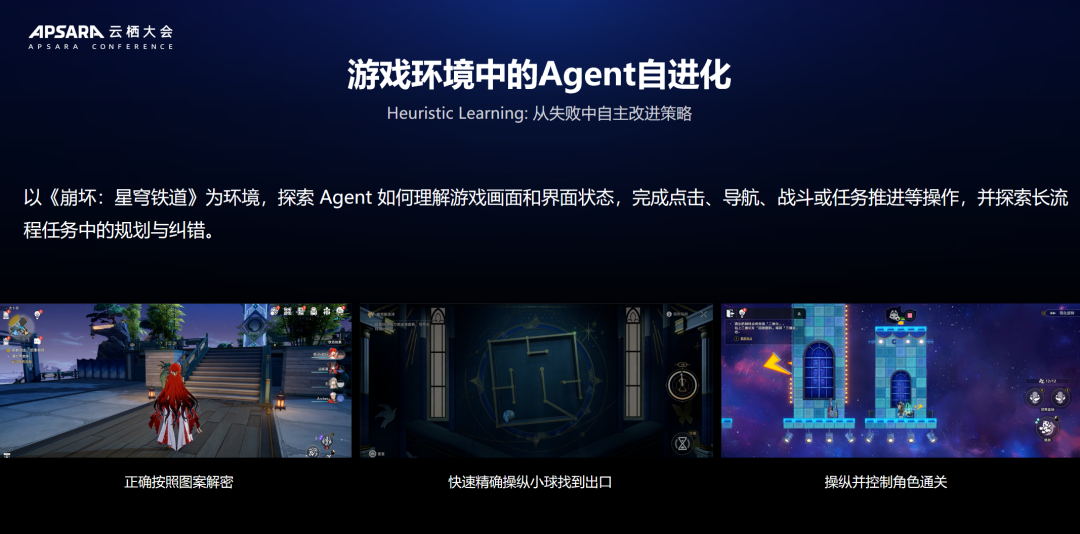
写到这里,前面的线总算对上了:
AI帕姆和AI Gameplay走到玩家面前,EchoX进入研发流程,自进化Agent又把游戏变成练级场。
AI进入游戏,游戏反哺AI。
这回真闭环了。
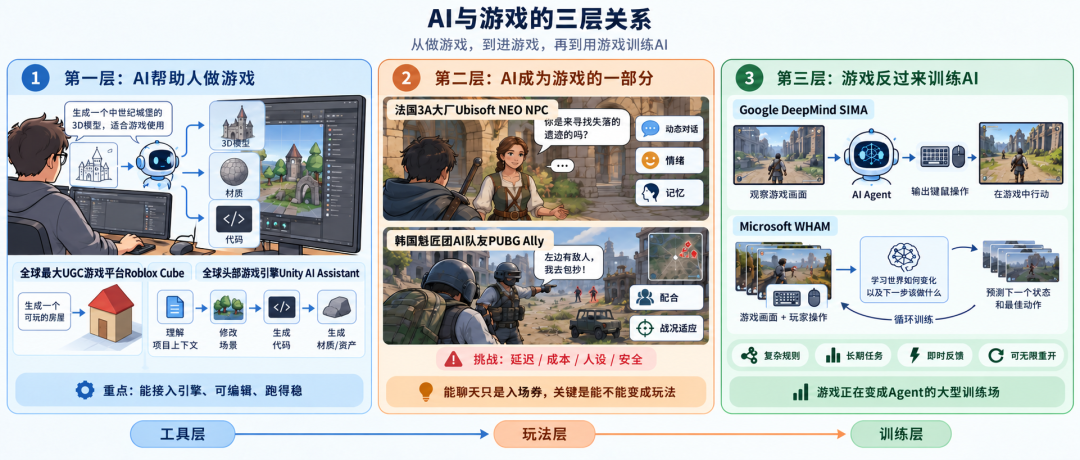
有意思的是,把镜头拉远,全球头部玩家基本也在同一张地图上折腾。
 △
图片由AI生成
谷歌DeepMind、微软在用游戏训练Agent和世界模型,Roblox、Unity则把AI塞进创作工具和引擎。
米哈游并不是唯一这么做的,特别之处在于,它已经把三条路线都走了一遍,还开始把它们连成一个完整的循环。
不过,这条路远没到大结局。
GDC 2026报告显示,36%的游戏从业者已经在使用生成式AI,52%却认为它正在给行业带来负面影响。
一边真香,一边警惕。
类似的分歧,也出现在米哈游玩家社区里。
有人期待AI带来真正千人千面的世界,也有人担心,所谓技术升级最后又变成批量生产剧情、美术和NPC的流水线。
争来争去,我看到一句话最实在:
玩家只需要好玩,内容是AI生成的还是脚本写的,对玩家来说没什么区别。
确实。
NPC再能聊,模型参数再大,如果剧情没意思、玩法不好玩,玩家照样用脚投票。
反过来,只要AI真的带来了以前做不到的体验,谁又会在意背后跑的是模型还是脚本?
技术最后都得退到幕后,体验才会留在台前。
而这场千亿豪赌能不能赢得玩家,大伟哥已经给出了一个验收节点。
在近日举行的米哈游2027校园招聘上海交通大学专场上,他表示:
尤其是我们今年开始做Coding模型之后,我觉得我们的进展是突飞猛进的。我有很强的信心,未来2到3年内,米哈游会是国产大模型团队里举足轻重的一员。
他甚至直接撂下一句:
如果做不到,你可以随时,一年两年之后过来打我脸。
??大伟哥是真豁出去了,我也是真期待住了(手动狗头)。
一键三连「点赞」「转发」「小心心」
欢迎在评论区留下你的想法!
— 完 —
🌟 点亮星标 🌟
科技前沿进展每日见
本文来自大风号,仅代表大风号自媒体观点。
