微软发布2nm AI芯片,吞吐量狂飙7倍




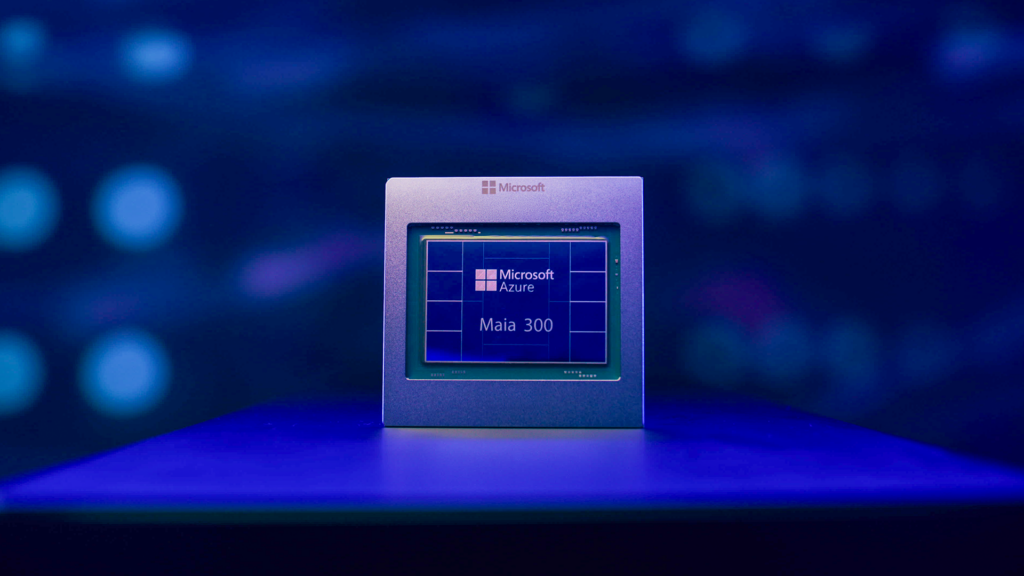
当地时间10月12日,微软宣布加速推进其自研AI芯片战略,Maia 200已在微软生产工作负载中投入使用,并正推出基于台积电2nm制程的第三代AI加速器Maia 300,预计将于2027年开始量产部署。微软计划自2027年起将Maia系列扩展至多吉瓦级部署,使其成为微软产品与服务的首要推理系统。
据微软介绍,Maia 200目前已服务于Microsoft Copilot等生产工作负载,并支持MAI团队开发下一代模型。GitHub Copilot与Microsoft Foundry预计将于今年年底前跟进部署。在这些工作负载中,Maia 200运行OpenAI模型、微软自有MAI模型以及领先的开源模型系列。微软方面表示,其AI服务规模带来的洞察,使硬件系统与软件应用之间能够进行独特的协同设计,从而优化企业应用与行业场景中的真实用例。
目前,Maia 200正在美国、欧洲和澳大利亚部署,在Microsoft Teams、Copilot和Cowork体验的内置AI能力方面,相比领先的GPU基础设施,每瓦token输出量最高提升1.7倍。微软表示,在Maia 200上运行AI模型与服务的经验,直接为Maia 300的设计提供了依据。
Maia 200和Maia 300这两代产品是共同设计的,旨在支持微软更广泛的AI服务:多步骤智能体工作将帮助GitHub更高效地提供编码体验;云规模模型服务将帮助Microsoft Foundry支持多样化架构与部署环境;为MAI团队提供推理与数据生成;以及延迟敏感的交互,将帮助Dragon Copilot扩展工作流并减轻临床医生的行政负担。
Maia 300被微软定义为“一套完整的智能系统”,专为当前涌现的新型AI工作负载而设计,包括长上下文推理、延迟敏感的对话体验,以及持续的多步骤智能体任务。微软预计,通过提升整个系统的效率,Maia 300相比领先的GPU系统,每兆瓦可多输出40%的token;在完整的96加速器配置下,其机架级token吞吐量可达Maia 200的7倍。
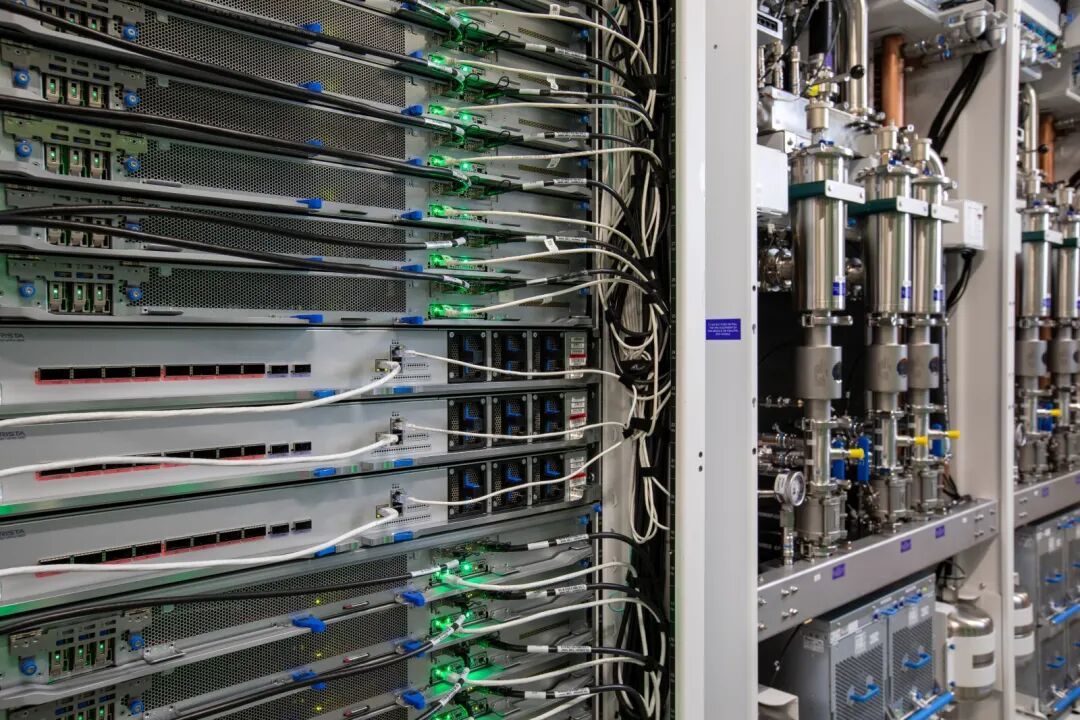
Azure Maia 300 system
微软强调,Azure Maia系统围绕其大规模运行的真实工作负载以及未来数年预期构建的模型而设计。由于芯片开发周期长达数年,微软的软件与硬件团队尽早协作,预判架构、规模与能力,并将这些需求转化为更大的内存容量、更高的带宽以及更多作为单一系统运行的加速器。
作为Azure Maia计划的第三代产品,微软表示,Maia 300采用推理优先架构,针对长上下文、内存密集型和解码密集型AI工作负载进行优化,在云规模上平衡计算、内存带宽、网络与能效。
具体硬件参数方面,Maia 300采用了新的多芯粒架构,将计算、内存控制器与I/O功能分离,核心的计算芯粒采用台积电N2P制程节点制造。其单芯片配备八个HBM4堆栈,在950瓦TDP内实现18.0 TB/s的峰值内存带宽,同时支持增强型MXFP4等先进低精度格式以降低内存与带宽需求。在机架级配置中,Maia 300系统在167千瓦功耗包络内集成96个加速器,提供27.6 TB的HBM总容量和1.7 PB/s的聚合HBM带宽;微软预计其每兆瓦token输出量较领先GPU系统高出40%,机架级token吞吐量可达Maia 200的7倍。
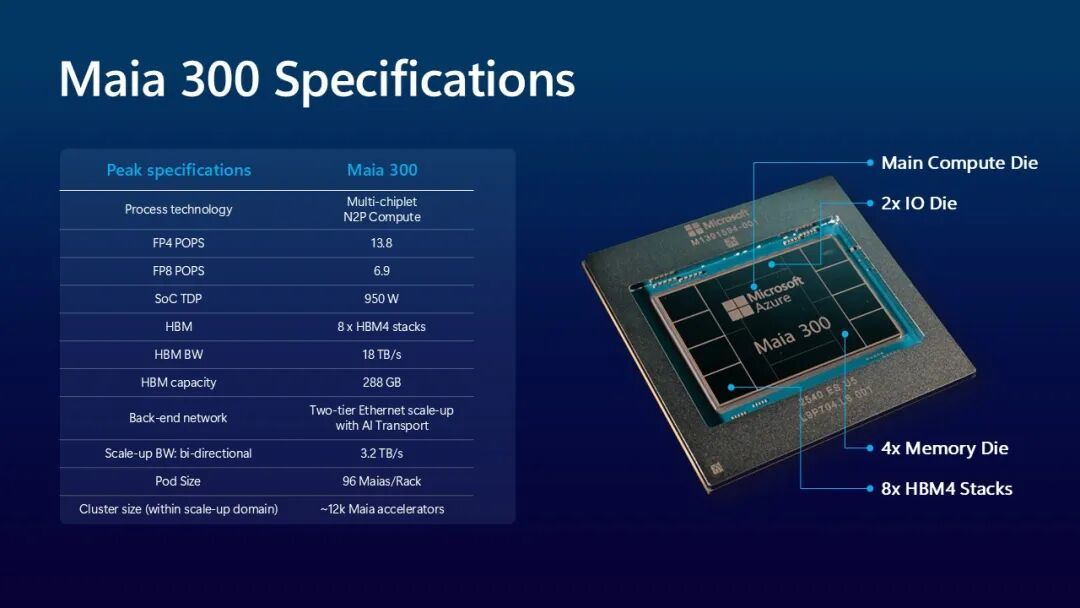
Maia 300系统的关键能力包括:
更少的数据移动,更有用的计算:在大规模推理系统中,高效移动数据而非原始计算能力,正日益成为瓶颈。Maia 300的软件定义数据流架构与AI辅助内核优化协同工作,最大化局部性、减少数据移动,并提升计算、内存与网络资源的利用率。通过将数据流视为首要设计原则,Maia 300相比传统GPU架构实现了显著的每瓦性能优势。
每一瓦内更高的内存带宽:随着AI工作负载日益受上下文与内存约束,Maia 300提供业界领先的每瓦HBM带宽。八个HBM4堆栈在950瓦TDP内提供18.0 TB/s的峰值内存带宽,使大模型与长上下文工作负载得以高效执行。专用内核支持将片上SRAM用作软件管理的暂存区,减轻HBM压力。
Chiplet架构提升效率:新的多芯粒架构将计算、内存控制器与I/O功能分离,提升效率、可扩展性与成本结构。计算芯粒基于台积电N2P制程节点制造,以最大化每瓦性能。
更大上下文,更丰富智能:通过针对先进低精度格式(包括增强型MXFP4)的设计,Maia 300降低了计算与KV缓存存储的内存和带宽需求。其结果是相同功耗包络内更大的上下文窗口、更高的吞吐量和更高的模型效率。
数据中心规模的纵向扩展网络:Maia 300将网络视为软件定义数据流架构的无缝延伸。数据流操作跨越计算、内存与网络资源,作为单一系统运行,而非通过独立的通信层移动数据。Maia加速器之间的高带宽互连针对张量并行进行优化,而定制AI传输则在加速器与机架之间提供高性能、可靠的纵向扩展通信。AI优化传输利用基于以太网的网络基础设施,实现统一拓扑,从单一机架高效扩展至数据中心规模部署。
每一机架更高的AI吞吐量:Maia 300机架系统在167千瓦功耗包络内集成96个加速器,在高速度纵向扩展域内提供27.6 TB HBM容量和1.7 PB/s聚合HBM带宽。这一密度使微软能够从每个机架服务更多并发AI交互和更大工作负载,提升数据中心容量与扩展AI服务的经济性。
据介绍,Maia 300将于2027年开始量产部署。
微软将Azure Maia定位为其“前沿转型”战略的核心组件。微软称,未来不会由单一模型、单一芯片或单一创新所定义,模型与芯片选择是其愿景的内在组成部分。微软的独特之处在于,能够在开放、异构且模型多样化的平台上,从芯片到系统再到智能体进行优化。该平台是前沿转型的核心,而Azure Maia是微软扩大访问、加速创新并帮助客户从AI中获取更多价值的基础性组件。
编辑:芯智讯-浪客剑
本文来自大风号,仅代表大风号自媒体观点。
