从AI存储到EDA加速, 2026湾芯展上的华为把基础能力放到台前



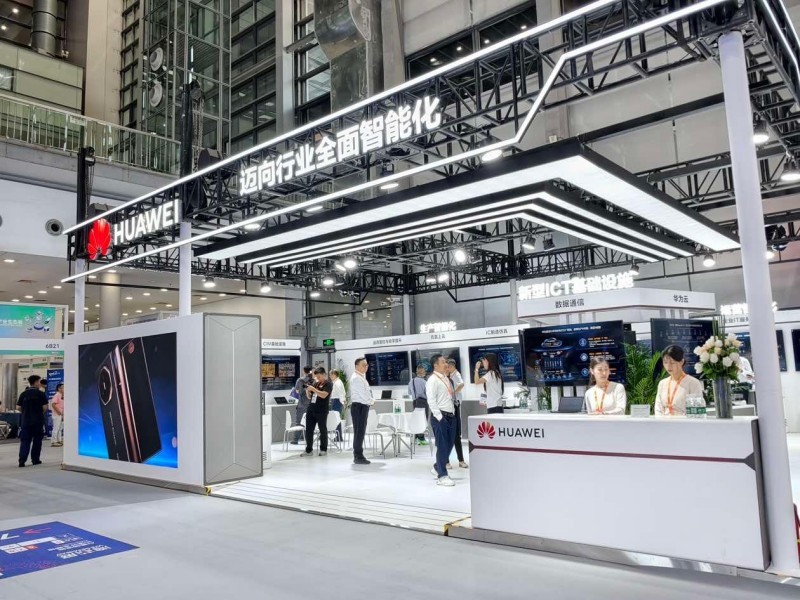
在2026湾芯展华为展台,“迈向行业全面智能化”的主题并没有停留在大模型或算力芯片的单点展示。OceanStor A800高性能AI存储、企业级AI Coding方案、鲲鹏920新型号服务器以及面向EDA、OPC的HPCKit,被放在同一条叙事线上。它们分别对应AI时代常被低估的几件事:数据能否高效喂给算力,模型能否在企业内安全运行,芯片设计软件能否在底层计算平台上获得稳定加速。
AI基础设施 先把数据路打通
大模型训练与推理的瓶颈,越来越不只在算力卡本身。模型参数、训练语料和推理过程中的KV Cache都在持续拉高数据吞吐需求。现场展示的OceanStor A800,正是围绕这一问题展开。其通过NDS直通NPU,试图缩短数据从存储到计算侧的路径,减少复杂协议栈与数据拷贝;华为给出的现场资料显示,这一方案可带来40%的性能提升。
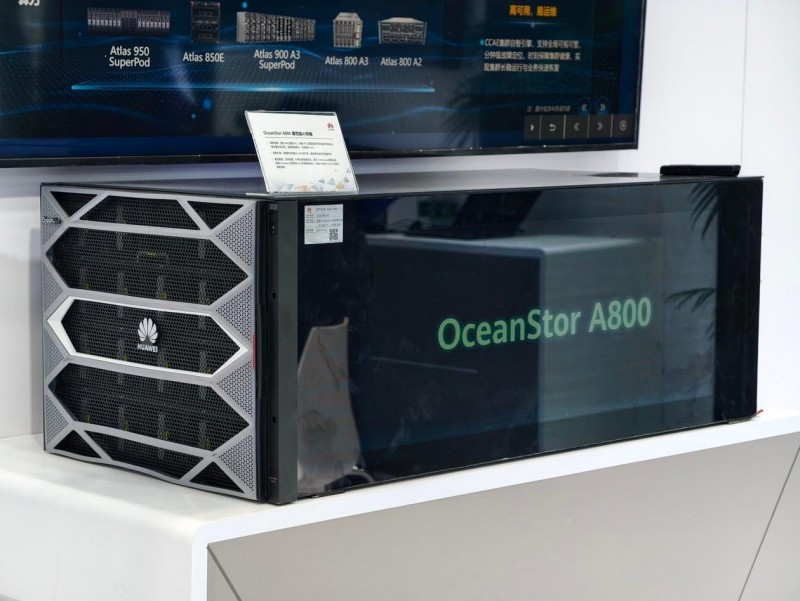
A800的另一层重点是推理阶段。它支持向量、KV等数据范式,并以Unified Cache打通从显存到SSD的多层缓存能力,目标是把KV Cache做成可共享的PB级资源池。单集群最大支持2048控扩展,则回应了训练、推理集群扩大后对性能和容量密度的双重要求。对企业而言,AI基础设施的竞争已经从“有没有算力”延伸到“数据能否跟上算力”。
AI Coding 让企业把智能编码留在本地
在AI Coding方案中,华为给出的架构分为Agent、模型与算力三层。上层可接入OpenCode、Z Code、合见UDA及自研Agent,面向嵌入式软件、企业IT、CI/CD和芯片设计等场景;模型层兼容DeepSeek、通义千问、Kimi、智谱等主流模型;底层则由Atlas 950 SuperPod、Atlas 850E、Atlas 900 A3 SuperPod、Atlas 800 A3与Atlas 800 A2等算力平台支撑。
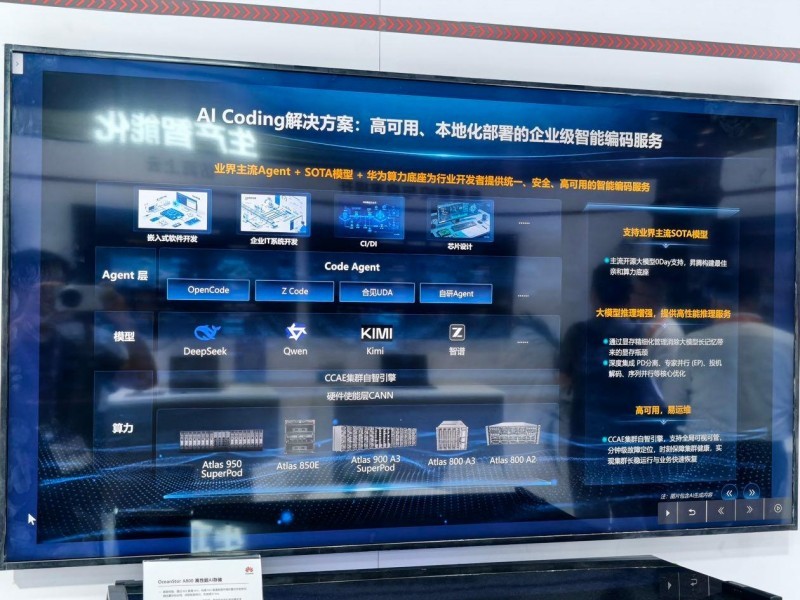
这套方案想解决的并非“让代码自动补全”这么简单,而是让企业在本地化环境中获得可管理的智能编码服务。面对长上下文和复杂工程,显存管理、PD分离、专家并行、投机解码和序列并行等优化直接影响推理效率;而集群层的可视可管、故障定位和快速恢复,决定了方案能否真正进入生产系统。模型能力不断趋同之后,部署、运维与数据边界,正在成为企业选择AI Coding方案的新门槛。
鲲鹏通算与EDA软件栈 一次面向设计环节的加速
展台另一条主线落在芯片设计基础设施。鲲鹏920新型号服务器搭载两颗鲲鹏920处理器,支持32条DDR5 DIMM、最高4TB内存,并提供面向不同存储需求的2.5英寸或3.5英寸盘位方案。它所服务的并不仅是通用服务器市场,也为EDA仿真、计算光刻等对内存容量、并行能力和稳定性更敏感的负载提供底座。
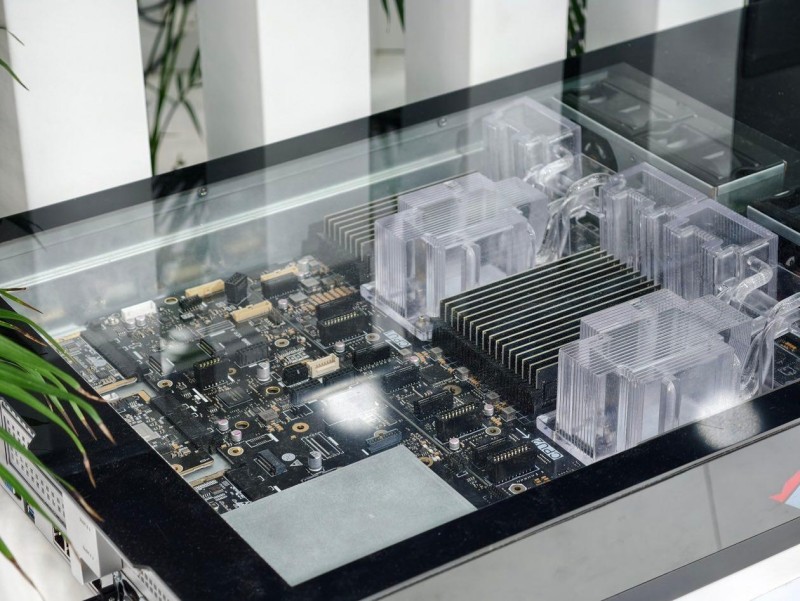
与硬件配套的HPCKit,则把优化下沉到数学库、并行库、编译器、操作系统和鲲鹏硬件平台。现场展板显示,天元稀疏直接法求解器对比x86 SPR+Pardiso端到端性能领先90%以上,KuLitho计算光刻库可助力OPC应用性能提升50%以上;KUPL与毕昇编译器也分别给出10%以上的提升指标。这些数字需要在不同工艺、数据规模和应用版本中继续验证,但方向已很清晰:在EDA这类高门槛软件场景里,芯片、服务器和基础软件必须一起做优化,单靠硬件替换很难获得完整收益。
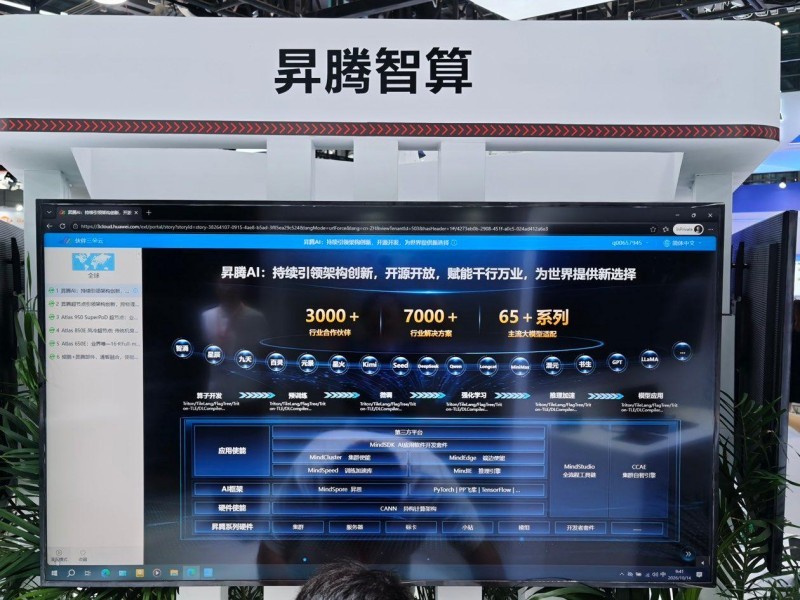
热点科技洞察:华为在湾芯展呈现的,不是一组彼此独立的产品,而是一条从AI数据、算力调度、企业级应用,到芯片设计计算的底层能力链。半导体与AI产业进入深水区后,单一设备或单一模型已很难解决真实生产问题。能否把存储、算力、软件栈和运维体系协同起来,才决定了方案能否从展台走进企业与工厂。
本文来自大风号,仅代表大风号自媒体观点。
