卡加了,吞吐为何没跟上?大模型推理中的等待,有了新解法




机器之心编辑部
大模型走向大规模在线服务,一个常见却又有些反直觉的现象是:卡加得越来越多,吞吐却涨得越来越慢。
问题出在哪?在 DeepSeek 等 MoE 模型的一类部署中,多组计算卡并行处理大量请求,每组既处理各自的请求,又要通过跨组通信,共同完成每一步解码。这意味着解码是齐步走:只要最忙的一组没算完,其他组算得再快也只能等。
更麻烦的是,请求即使分得一样多,各组实际承担的负载也可能不同,于是较轻的一组提前算完、空等最忙的一组,就成了常态。这种等待会随 token 生成反复发生,每一步都等一点,累积下来,部署规模扩大的收益便被悄悄吃掉了。
所以,瓶颈并不卡在算力那里,而是卡在「谁来等谁」上。
针对这一瓶颈,香港科技大学周子杰团队与华为 2012 实验室理论部联合提出 BalanceRoute。团队的思路很直接:先把问题说清楚,再谈优化,即通过数学建模刻画同步等待,再将短期负载预测转化为在线路由决策。
效果也经得起检验。在论文的 96 卡主实验中,采用实际预测器的 BR-H 相对所比较的最强基线,解码吞吐提升约 15%。
这项工作已被 NeurIPS 2026 接收,并已部署于双方共建的 MaaS 推理服务系统 MathBot-Pie。
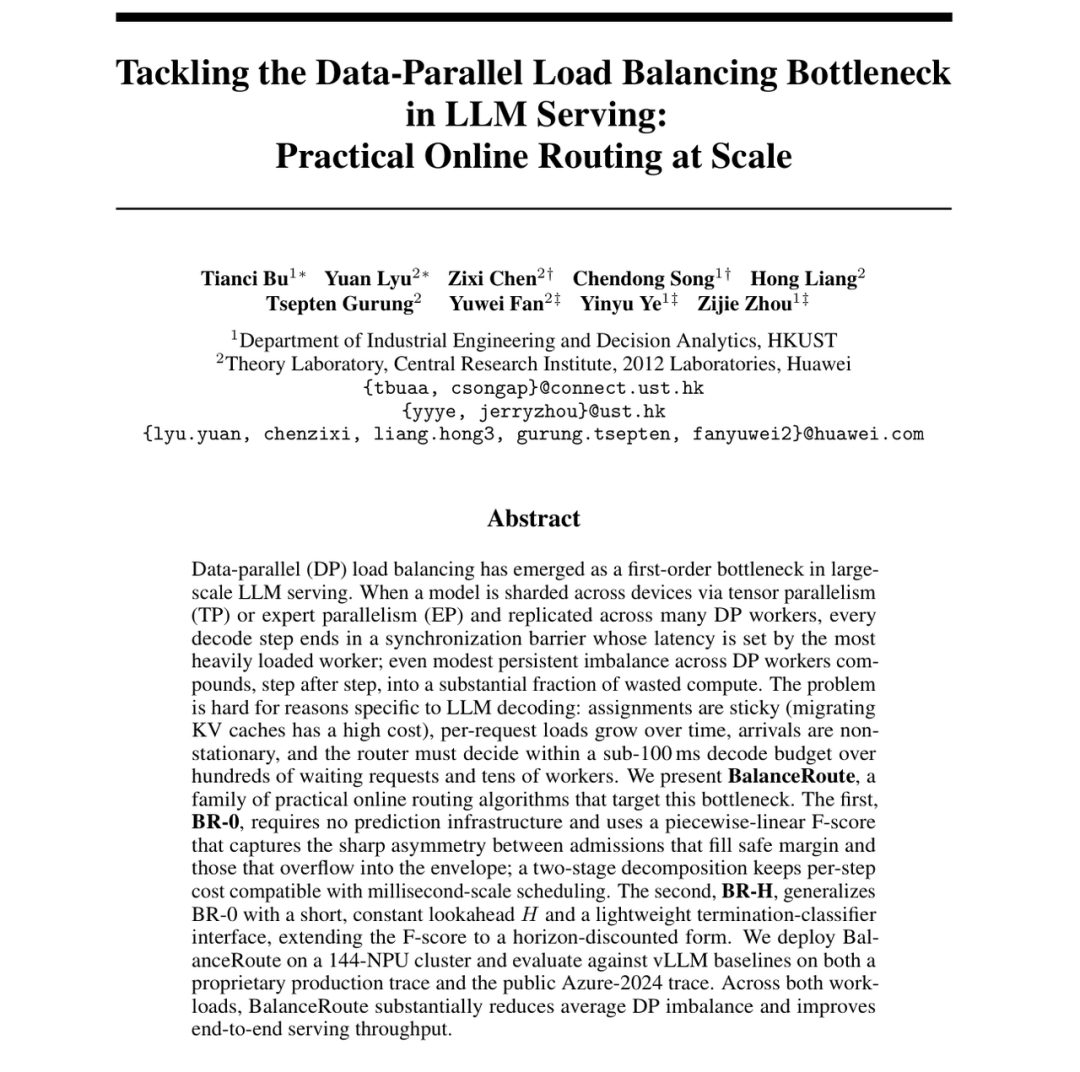
论文标题:Tackling the Data-Parallel Load Balancing Bottleneck in LLM Serving: Practical Online Routing at Scale
论文链接:https://arxiv.org/pdf/2605.06113
代码链接:https://github.com/b010001y/BalanceRoute
请求数相同,
负载仍会不同
大模型生成回答,通常分为预填充(prefill)和解码(decode)两个阶段。预填充先处理整段输入,把后续生成需要复用的中间结果保存为 KV 缓存;解码再逐个生成输出 token。每生成一步,都需要读取此前输入和已生成内容对应的 KV 信息。
在本文研究的预填充 — 解码分离(PD 分离)系统中,这两个阶段由不同的计算资源承担。请求完成预填充后,路由器为它选择一个解码工作单元,已有的 KV 缓存也随之传送过去。一个单元可由多张计算卡组成。
轮询等方法可以依次把新请求分给各组,却没有区分每条请求需要处理多少 KV 信息。同样处理两个请求,长上下文对应的缓存更多,单步读取与计算的负担也可能更重。因此,在同步约束下,请求数相同,较轻的组等待较重的组仍是常见的问题。
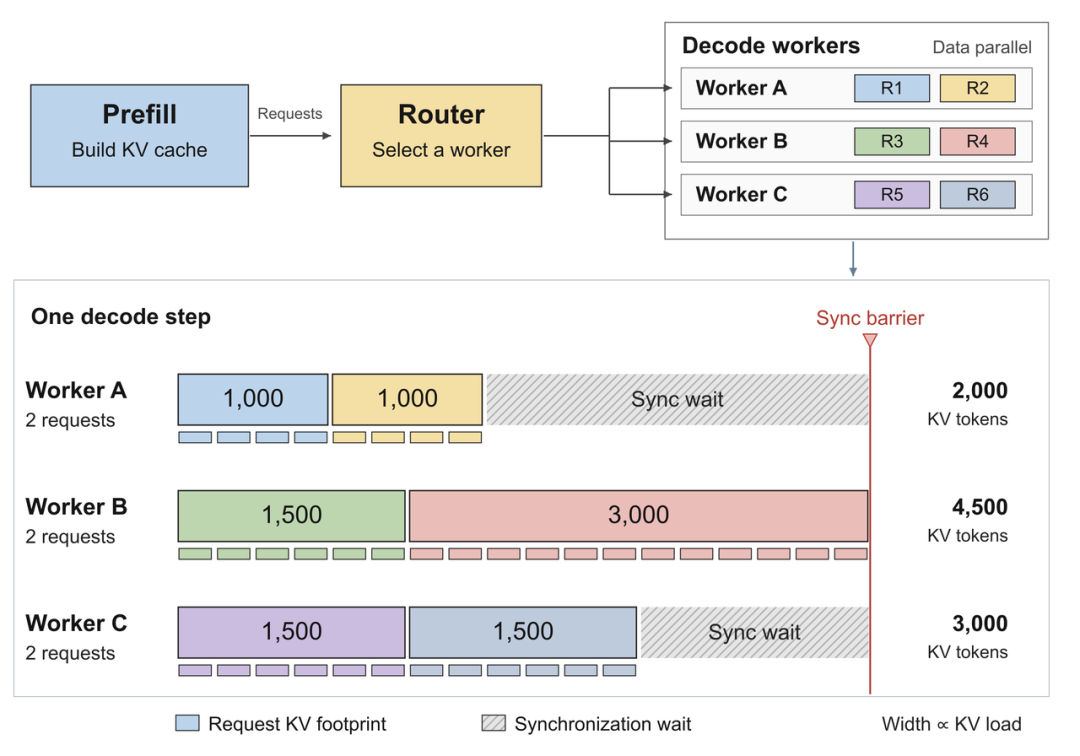
图 1|预填充完成后,请求被分配到解码工作单元。下方展示本文部署中解码步内的计算与同步:每组都是两个请求,KV 总量却不同,较轻的组会等待最忙的一组。斜线为等待示意。
负载还会随生成不断变化。每生成一个 token,请求就会新增相应的 KV 信息,下一步需要处理的上下文也随之变长,请求完成,则退出后续解码计算。与此同时,预填充侧还在送来新请求。某组可能连续多步变忙,也可能因一条请求结束而突然减轻负担。
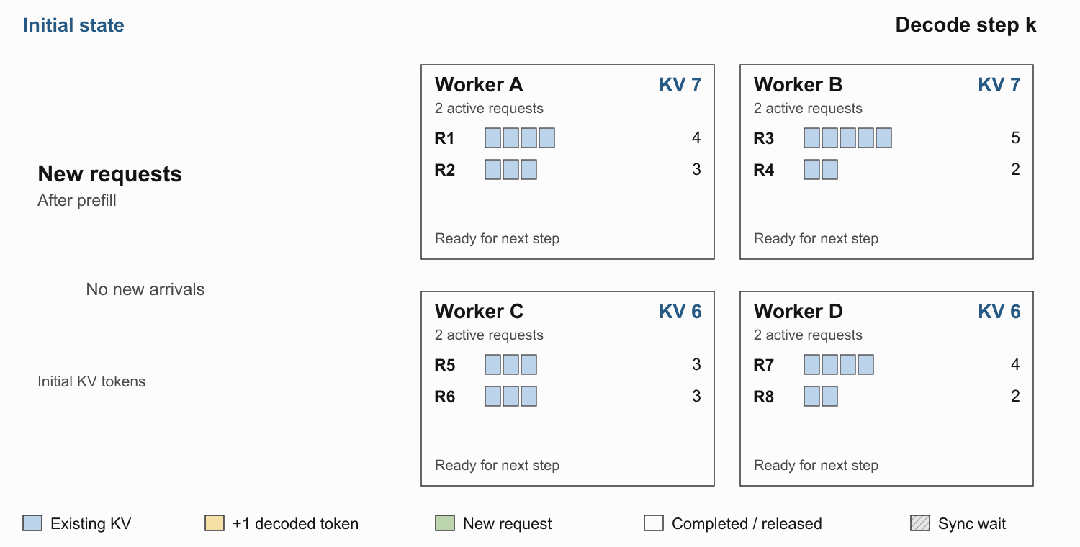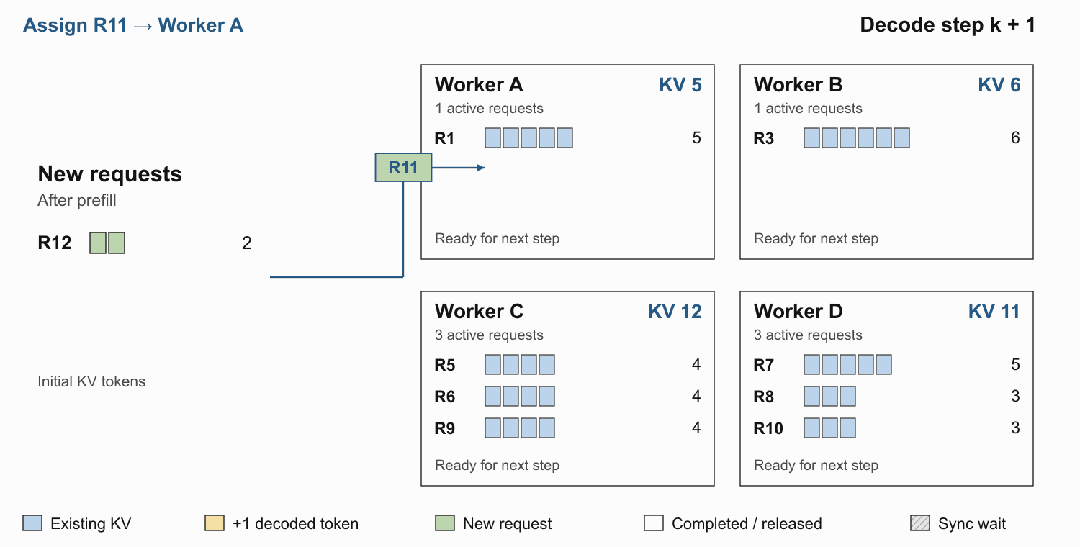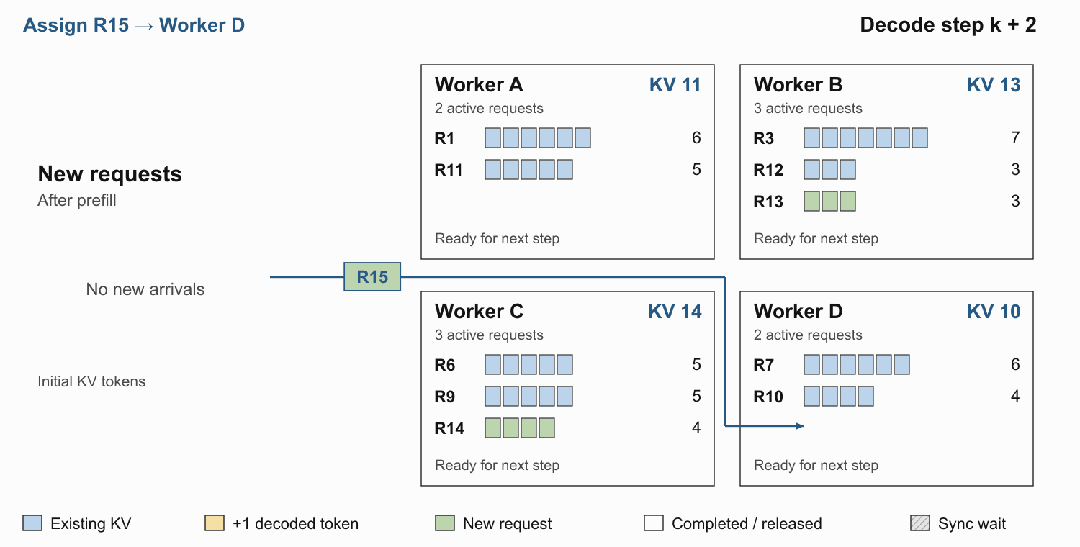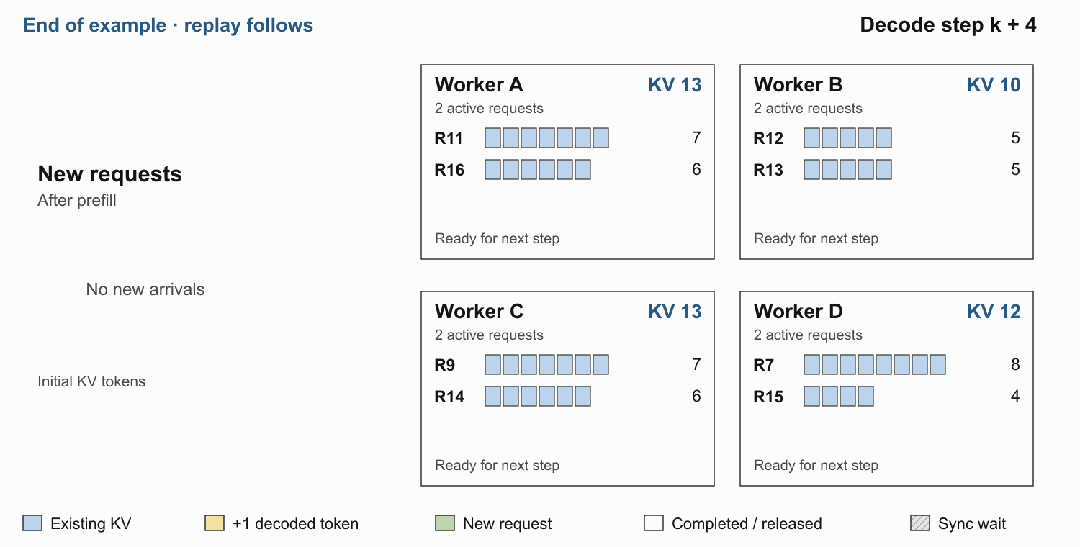
图 2|解码中的负载变化:新请求带着预填充得到的 KV 缓存加入,已有请求随生成增长,完成的请求退出。较轻的单元等待当前最忙的一组;同一请求始终留在原单元。
把运行中的请求转交给另一组,需要搬运已经积累的 KV 缓存。考虑这一开销,论文采用分配后不迁移的设定:路由器必须在输出长度未知、负载不断变化时作出选择,请求随后留在该单元直到结束。
数学建模,
把同步等待变成决策目标
从每一步的同步关系出发,通过数学建模,把各单元与最重单元之间的负载差相加,得到不均衡指标。设第 k 步中,单元 g 负载为 L_g (k),最重单元负载为 M (k),一共有 G 个单元。单步不均衡可以写作:
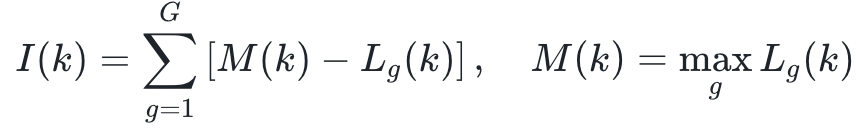
I (k) 这个量越大,说明各个单元之间的算力分配越不齐。这个指标刻画了同步等待对应的空闲,长期目标则是减少它在连续解码步骤中的累积。
如图 3,四组负载为 10、7、6、5,此时 I (k) 为 12。给 C 增加 4 单位负载,恰好填平它与最重单元的差距,I (k) 降至 8;若增加 5,C 就变成新的最重单元,让其他三组各多等一份,I (k) 为 11。
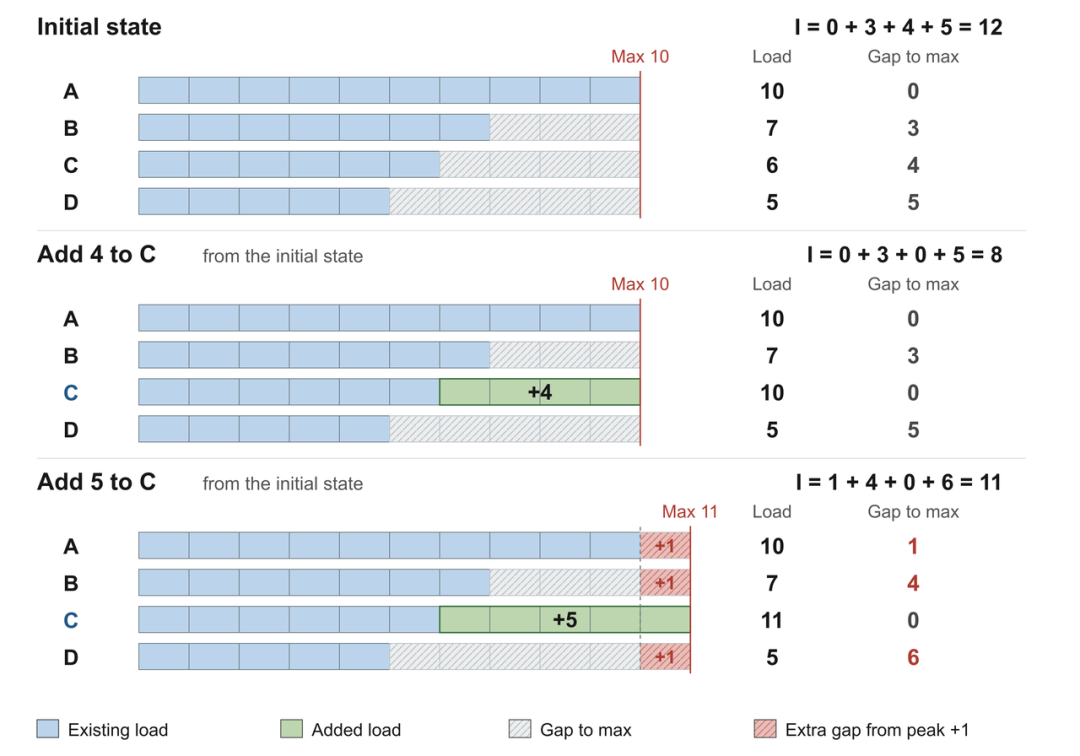
图 3|填补空闲与抬高峰值的权衡。两个接入方案均从同一初态出发;蓝色为已有负载,绿色为新增负载,斜线为空闲差额,粉色突出峰值上升带来的额外等待。数值为示意负载单位。
这个例子揭示了分配的关键权衡:接入新请求能填补较轻单元的空闲,但若把它推成新的最重单元,就会增加其他单元的等待。接下来,需要把这种比较延伸到未来多个步骤。
预测多远,
取决于路由真正需要什么信息
一次分配的影响会延续到后续解码。两组此刻一样忙,其中一组若有请求即将结束,就可能很快释放负载。BalanceRoute 的 BR-H 因此引入 H 步窗口,估计各组近期的负载变化。
窗口并非越长越好。H 太短,可能看不到即将结束的请求;H 太长,即使现有请求的长度预测准确,尚未到达的新请求及后续分配也会改变负载,让更远处的状态难以确定。
预测目标也随之具体化:对运行中的请求,先估计它在窗口内结束的概率,再估计 “若在窗口内结束,还需多少步”。二者共同给出它在窗口内预计还会运行多久。若请求持续超过窗口,就不必精确区分它在更远处还会生成多少内容。
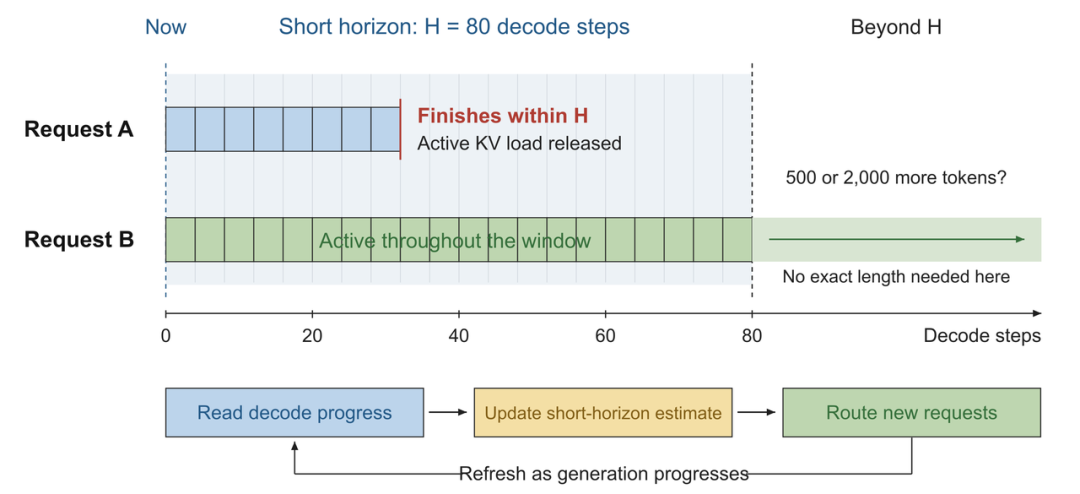
图 4|预测窗口内的请求结束情况,形成短期负载估计,再据此评分、分配并更新。上方色条表示请求持续活跃的时间;H=80 为示例窗口,A、B 为示意请求。
这些预测最终要变成具体的分配。BR-H 先估计各单元未来 H 步的负载,再比较接入候选请求后,每一步能填补多少空闲、又会带来多少额外等待,将收益与代价汇成评分,并降低较远步骤的权重。为控制决策开销,路由器结合可用槽位和预计余量挑选单元,再按评分选择请求或请求组合,逐步完成分配。
每次接入后更新预计负载,下一轮再依据最新运行状态重新判断。预测、评分和分配由此形成持续更新的过程。
从模型,到真实系统中的毫秒级路由
模型要带来收益,路由决策需要跟上解码节奏。团队在 vLLM-Ascend 之上实现了有状态代理,统一维护各工作单元的负载、空闲槽位和生成进度。预填充完成的请求先进入等待池,让 BR-H 能结合全局状态比较候选请求的分配;解码端的流式反馈则持续更新生成进度。 这套设计通过现有接口接入,无需修改推理引擎核心。系统复用预测、增量更新负载,并将组合选择限制在小规模候选集合内,以控制每轮调度开销。
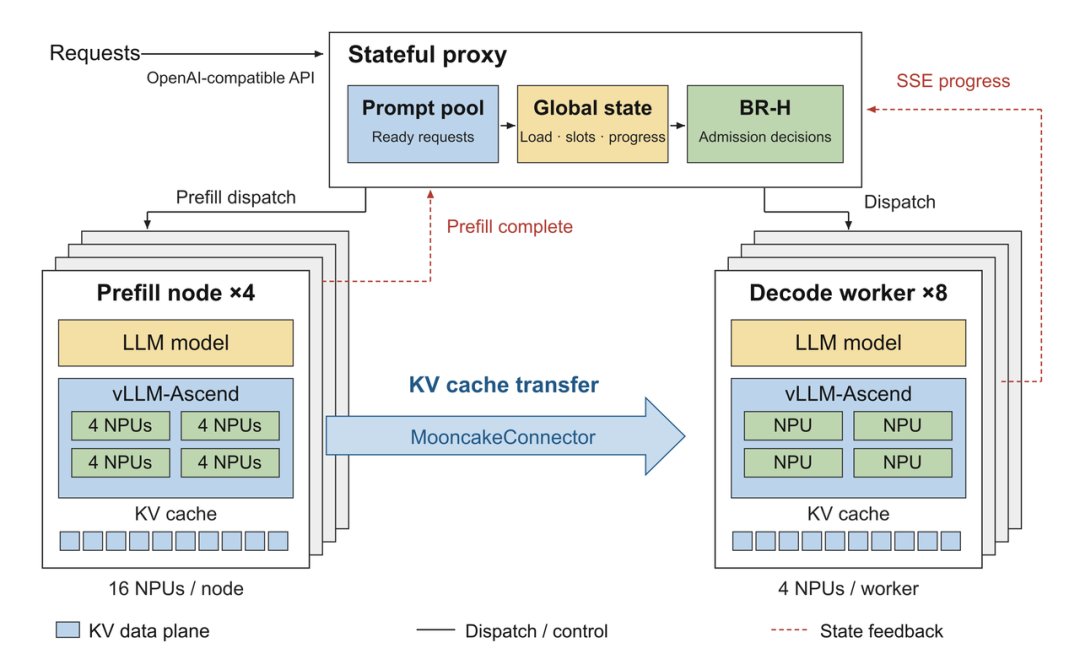
图 5|系统结构简化示意。灰色实线表示调度,蓝色粗箭头表示 KV 传输,红色虚线表示状态回传。
主实验使用 96 张昇腾 910C NPU,运行 DeepSeek-V3 671B(W8A8),其中包含 8 个解码工作单元。在该部署中,单轮调度耗时的中位数为 1.20 毫秒,99% 分位为 2.77 毫秒,低于约 60 毫秒的单步解码时间预算。
在接近饱和的高负载条件下,团队回放企业生产请求记录和公开 Azure-2024 请求记录,与轮询、最短队列等四种常用路由策略比较。采用实际预测器的 BR-H,相对各数据集上吞吐最高的基线,解码吞吐分别提升 15.4% 和 14.5%,输出 token 间隔的尾部延迟也同时降低。这些收益来自相同模型与 NPU 配置下的请求分配改进。
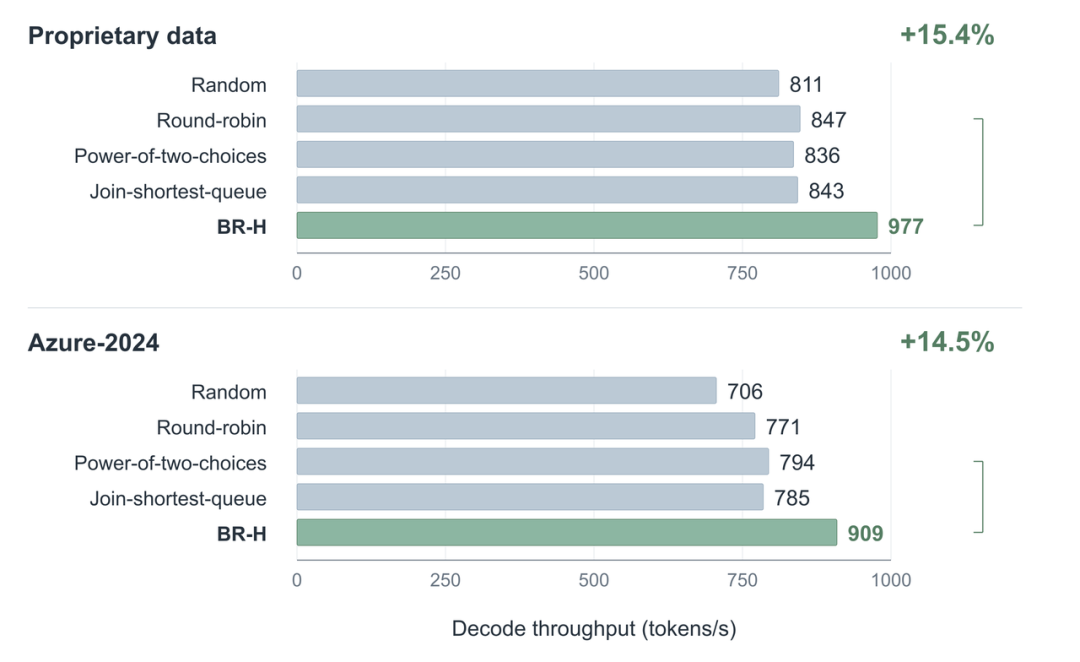
图 6|实际预测器下的解码吞吐。图中展示已有 vllm-router 基线与 BR-H 的对比。
在系统应用方面,BalanceRoute 已部署于双方共建的 MaaS 推理服务系统 MathBot-Pie。MathBot-Pie 以 cache 感知调度为基础框架,通过 Agent 实现快速自动适配,以及高性能算子和模型的自动构建与优化,综合推理框架、模型计算与底层算子的联合优化,致力于实现低时延与高性价比;而 BalanceRoute 正是其降低跨组同步等待、提升在线解码吞吐的关键所在。
把运筹学写进推理系统
在请求不断到达、KV 缓存随生成增长、请求结束又释放负载的过程中,跨组同步让这些变化相互牵连,很难直接判断一次分配对整体效率的影响。团队通过建模理清这些关系,提炼出反映同步等待的负载不均衡指标 I (k),把路由问题转化为一个有明确目标的优化问题。
沿着这个目标,团队进一步分析负载随时间的变化并把预测重点放在近期哪些请求会结束上,形成短期预测与路由策略,并在真实系统中验证了收益。
这也是香港科技大学周子杰团队探索 OR for LLM serving(面向大模型服务的运筹学研究) 的出发点:通过建模理解复杂系统并明确该优化什么以及需要哪些信息,再让这些认识指导实际决策。
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com
本文来自大风号,仅代表大风号自媒体观点。
