一出手就是斩杀线 DeepSeek V4.1 Flash成本低到发指:1美元13亿Token



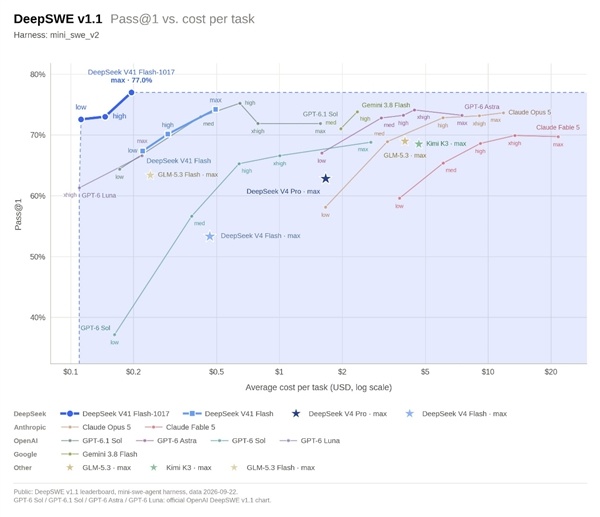
快科技10月17日消息,今天下午DeepSeek又发布了V4.1 Flash-1017版大模型,这几天大家都在期待国产AI大模型升级,结果还是DeepSeek打了头阵,而且这波升级提升非常大。
具体的性能水平及变化之前有报道了,大家应该会注意到DeepSeek这次自己还发了一张帕累托曲线,也就是大家常说的AI斩杀线,V4.1 Flash-1017这次又是封神一般的水平,每任务成本只有Fable、Astra等大模型的1/50-1/100之间,性价比至少高出四五十倍。
DeepSeek是怎么做到这样的斩杀线的?大家都知道他们有极强的AI优化能力,在降低成本这方面可以说极尽所能,而vllm_project发布的下面这张图可以清晰地展示出DeepSeek在AI硬件上的优化有多强。
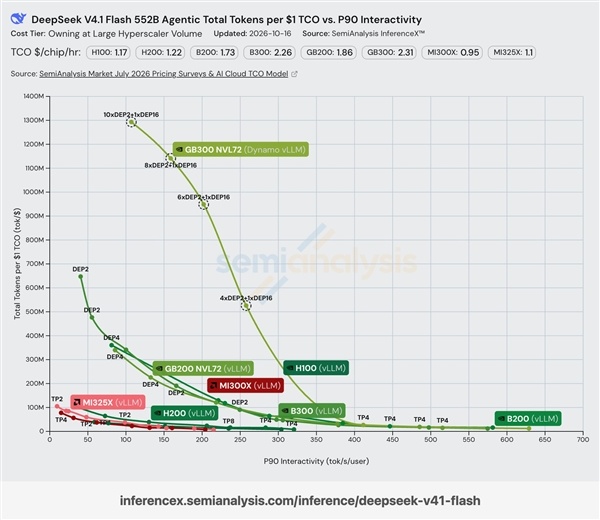
这张图是对比的是SemiAnalysis AgentX基准测试,在GB300 NVL72及Dynamo vLLM平台上,V4.1 Flash跑出了1美元1.3B Token的成绩,P90 交互速度超过 100 tok/s/user。
1美元13亿Token,算下来1M Token只要0.00077美元,这比V4.1 Flash的输入价格0.15美元便宜太多了。
当然,这两个价格实际上也不能这么简单换算,1美元13亿Token的Tco成本是算力端的,API定价还要考虑更复杂的情况,只不过DeepSeek的超低成本让他们在这方面有了无人能敌的优势。
正因为DeepSeek V4.1 Flash在成本上有堪称逆天的优势,各大平台也敢于提供超低的收费,OpenCode、CommandCode的10美元套餐中最近都能用量打到了80-120美元,OpenCode这两天更是免费开放了,现在聚合路由平台上V4.1 Flash自己的用量都是百万亿Token级别的,一家能顶六七家友商的用量。
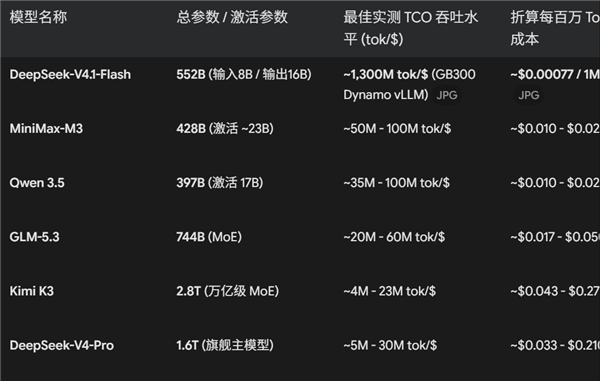
让AI对比了多个开源大模型的TCO成本,万亿参数内的其他大模型的产出最多也就是V4.1 Flash的1/10,如果是1.5-3万亿参数量的大模型,那成本差距更是可以达到40-50倍以上,完全没法比。
这还要说明一点,这个TCO成本还是V4.1 Flash-0910的,不是今天发布的1017版,后者虽然API定价没变,但大幅优化了Token效率,减少了Token消耗量,不同任务中程度不同,体感上来说至少也降低了一半的消耗,意味着TCO成本还能再次大降一波。
【本文结束】如需转载请务必注明出处:快科技
责任编辑:宪瑞
本文来自大风号,仅代表大风号自媒体观点。
